Extracción de Datos de Recibos con Google Gemini y OCR: Cómo Automatizar la Entrada de Datos
Un recibo de €18 puede generar más trabajo administrativo que una factura de €18.000.
La razón no es el importe.
Es que alguien necesita transformar una imagen en datos:
foto → proveedor → fecha → importe → impuesto → categoría → registro → comprobación.
Multiplica ese proceso por 500 recibos mensuales y aparece un problema que parece documental, pero en realidad es un problema de transformación y validación de datos.
El OCR tradicional resolvió parcialmente la primera etapa: convertir una imagen en texto.
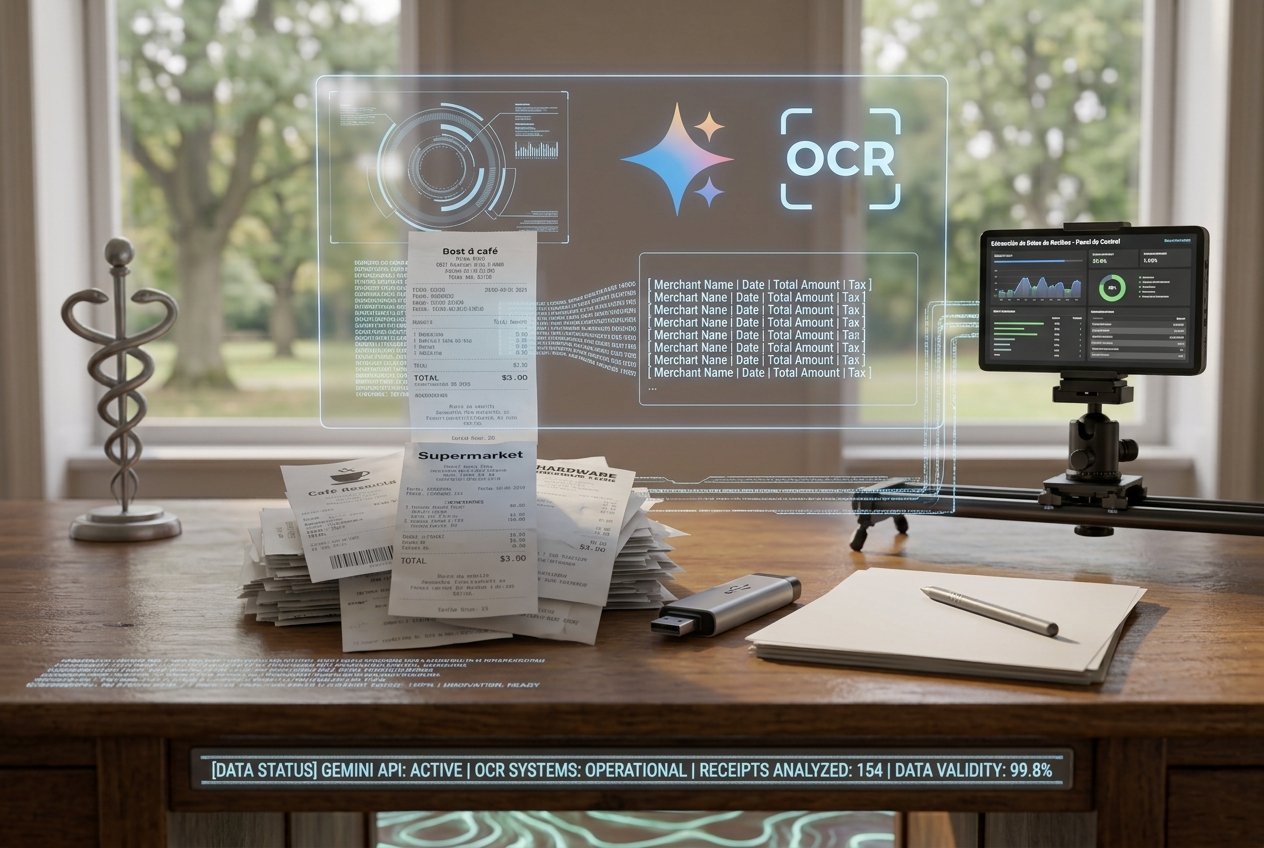
Modelos multimodales como Google Gemini permiten avanzar un paso más: interpretar el documento y devolver información estructurada.
Pero existe una diferencia importante entre:
«La IA leyó correctamente el recibo.»
y:
«Los datos pueden entrar de forma segura en el sistema contable.»
Entre ambos puntos está casi todo el trabajo interesante.
OCR e IA multimodal no hacen exactamente lo mismo
OCR significa Optical Character Recognition.
Su función tradicional es reconocer caracteres dentro de imágenes.
Por ejemplo, una fotografía contiene:
SUPERMERCADO ABC
14/08/2026
TOTAL €48,73
El OCR transforma los píxeles en texto.
Eso ya elimina transcripción manual.
Pero todavía quedan preguntas:
- ¿Cuál es el proveedor?
- ¿Qué fecha corresponde a la compra?
- ¿€48,73 es subtotal o total?
- ¿Qué parte corresponde a impuestos?
- ¿En qué categoría debería registrarse?
- ¿Es un gasto empresarial?
- ¿Existe otro recibo idéntico?
Aquí empieza la diferencia entre extraer texto y comprender la estructura del documento.
El OCR puede leer perfectamente y aun así producir un registro incorrecto
Imagina este fragmento:
Subtotal: €91,00
IVA: €19,11
Total: €110,11
Pagado: €110,11
El OCR reconoce todos los números correctamente.
Pero un sistema mal diseñado podría seleccionar:
€91,00
como importe de la transacción.
No hubo error de reconocimiento.
Hubo un error de interpretación.
Esta distinción es importante porque mejorar únicamente la precisión del OCR no resuelve todos los errores contables.
Gemini añade una capa de razonamiento multimodal
La familia de modelos Gemini puede procesar diferentes tipos de información, incluidas imágenes y documentos, lo que permite pedir al modelo que no solo transcriba un recibo, sino que identifique campos específicos dentro de él.
Conceptualmente, podemos pasar de:
imagen → texto
a:
imagen → estructura.
Por ejemplo:
Proveedor: Restaurante CentralFecha: 12/08/2026Subtotal: 72.00Impuesto: 15.12Total: 87.12Moneda: EURMétodo_pago: VisaConfianza: alta
Ahora los datos están mucho más cerca de poder entrar en un sistema.
Pero todavía no deberían entrar automáticamente.
El mejor prompt no pide una descripción del recibo
Un prompt como:
Analiza este recibo.
deja demasiada libertad.
Para automatización necesitamos un contrato de salida.
Por ejemplo:
Extrae exclusivamente los siguientes campos:
- proveedor;
- fecha;
- número de documento;
- subtotal;
- impuestos;
- total;
- moneda;
- método de pago.
Si un campo no aparece claramente, devuelve null.
No deduzcas valores que no estén visibles.
Comprueba si subtotal + impuestos coincide con total.
Señala cualquier inconsistencia.
La palabra más importante puede ser:
null.
Enseñar a la IA a decir «no sé» mejora la automatización
Supongamos que el número de factura está borroso.
Tenemos dos sistemas.
Sistema A
Intenta completar:
A-18354
Sistema B
Devuelve:
invoice_number: null
El primero parece más inteligente.
El segundo puede ser más útil.
¿Por qué?
Porque permite crear una regla:
invoice_number = null → revisión humana
La incertidumbre se convierte en workflow.
Nunca uses únicamente un campo de «confianza general»
Supongamos:
Confianza del documento: 96%.
Parece excelente.
Pero podría esconder:
Proveedor: 99%.
Fecha: 99%.
Total: 99%.
IVA: 51%.
Número de factura: 43%.
Para contabilidad, el 96% general oculta precisamente los campos que necesitan revisión.
Es preferible trabajar con confianza por campo cuando la tecnología y arquitectura utilizadas lo permiten.
El pipeline correcto tiene varias capas
Una implementación robusta puede parecer así:
1. Captura
↓
2. Mejora de imagen
↓
3. OCR / visión
↓
4. Extracción estructurada
↓
5. Validación matemática
↓
6. Validación empresarial
↓
7. Detección de duplicados
↓
8. Clasificación
↓
9. Revisión de excepciones
↓
10. Registro contable
El error habitual es intentar saltar directamente de:
foto → asiento.
Google también tiene herramientas especializadas en documentos
Gemini no es la única tecnología relevante del ecosistema de Google.
Google Cloud Document AI está específicamente diseñado para extraer, clasificar y estructurar información procedente de documentos. Google ofrece procesadores especializados para diferentes tipos de documentación, incluidas facturas y recibos.
Esto plantea una decisión interesante.
Gemini
Más flexible.
Puede interpretar documentos diversos y seguir instrucciones complejas.
Document AI
Más orientado a pipelines documentales estructurados.
La herramienta adecuada depende del problema.
No todo necesita un modelo generativo
Si tienes 100.000 recibos con prácticamente la misma estructura, un pipeline documental especializado puede ser más predecible.
Si recibes:
- tickets;
- capturas;
- facturas;
- documentos extraños;
- fotos;
- formatos variables;
un modelo multimodal puede aportar flexibilidad adicional.
La pregunta no debería ser:
«¿Cuál IA es más avanzada?»
Sino:
«¿Cuánta variación existe en mis documentos?»
La variabilidad determina parte de la arquitectura.
El problema de las fotos tomadas con el móvil
Los recibos reales no parecen datasets de demostración.
Pueden tener:
- sombras;
- dobleces;
- reflejos;
- perspectiva;
- texto pequeño;
- tinta desvanecida;
- partes cortadas;
- fondos complejos.
Un recibo perfectamente legible para una persona puede ser difícil para un sistema automatizado.
Por eso, antes de cambiar de modelo, conviene medir qué tipo de imagen produce los errores.
Un pequeño cambio en captura puede superar una mejora del modelo
Supongamos que el error de extracción es 8%.
Analizamos 100 fallos.
Descubrimos:
- 47 por imágenes desenfocadas;
- 21 por recibos cortados;
- 18 por formatos complejos;
- 14 por errores del modelo.
Cambiar de IA solo ataca una parte del problema.
Una interfaz que diga:
«No se detectó todo el recibo. Vuelve a tomar la foto.»
podría eliminar más errores que migrar a un modelo más potente.
Ese tipo de análisis evita invertir en el componente equivocado.
La validación matemática debería ocurrir antes que la IA contable
Si extraemos:
Subtotal: €100.
IVA: €21.
Total: €119.
Existe una inconsistencia.
100 + 21 ≠ 119.
No necesitamos otro modelo de IA para descubrirlo.
Una regla determinista es mejor:
subtotal + impuesto = total
con tolerancia adecuada para redondeos.
Esto revela un principio importante:
Utiliza IA para la ambigüedad y reglas para lo que puede comprobarse matemáticamente.
IA + reglas suele superar a IA sola
Podemos diseñar:
IA
Extrae campos.
Regla
Comprueba suma.
Regla
Comprueba formato de fecha.
Regla
Comprueba moneda.
Base de datos
Comprueba proveedor.
IA
Sugiere categoría cuando existe ambigüedad.
Humano
Resuelve excepciones.
Cada componente hace aquello para lo que es más adecuado.
La detección de duplicados puede ahorrar más que la extracción
Imagina que un empleado fotografía un recibo.
Después lo envía también por email.
Más tarde aparece en una importación bancaria.
Ahora tenemos tres representaciones del mismo gasto.
Si el sistema solo es excelente extrayendo datos, puede crear registros duplicados perfectamente estructurados.
La automatización necesita detectar que representan el mismo evento económico.
Un identificador de duplicado puede utilizar varias señales
Por ejemplo:
- proveedor;
- fecha;
- total;
- últimos dígitos de tarjeta;
- número de factura;
- hora;
- similitud visual.
Regla sencilla:
mismo proveedor + misma fecha + mismo total → posible duplicado.
No deberíamos necesariamente eliminarlo automáticamente.
Podemos enviarlo a:
revisión de duplicados.
Los duplicados perfectos son los fáciles
El caso difícil:
Recibo A:
€48,72
Importación bancaria:
€48,73
Puede existir:
- redondeo;
- propina;
- conversión;
- ajuste.
Un matching exacto no encontrará relación.
La IA puede ayudar a evaluar candidatos, pero las reglas de tolerancia deberían estar claramente definidas.
El proveedor también necesita normalización
Un mismo comercio puede aparecer como:
- GOOGLE CLOUD
- GOOGLE *CLOUD
- GOOGLE CLOUD EMEA
- GOOGLE IRELAND
- GCP
Si cada descripción crea un proveedor diferente, los informes se fragmentan.
Una capa de normalización puede convertirlos en una entidad común cuando corresponda.
Esto permite responder:
¿Cuánto gastamos realmente con este proveedor?
sin sumar manualmente cinco nombres.
Pero normalizar demasiado también genera errores
«AMAZON» podría representar:
- AWS;
- marketplace;
- publicidad;
- servicios empresariales.
Agrupar todo automáticamente bajo:
Amazon
puede destruir información útil.
La normalización debería separar:
entidad
de:
tipo de gasto.
Proveedor y categoría no son lo mismo.
Gemini puede sugerir una categoría, pero no debería inventar tratamiento fiscal
Supongamos que el recibo dice:
Restaurante — €120.
El modelo puede sugerir:
Comidas.
Eso es clasificación administrativa.
Otra cosa es afirmar:
«100% deducible.»
La deducibilidad depende de:
- jurisdicción;
- finalidad;
- documentación;
- actividad;
- normativa aplicable.
Por eso, el pipeline debería mantener separados:
categoría contable
y
tratamiento fiscal.
Esta separación evita un error peligroso
Un gasto puede estar correctamente clasificado como:
Viajes.
Eso no significa automáticamente que cumpla todos los requisitos fiscales para deducción.
La IA puede ayudar a organizar.
La decisión fiscal necesita reglas y revisión correspondientes.
Para análisis fiscal más amplio, puedes consultar también Cómo Usar IA para Análisis Fiscal y Redacción de Informes Contables.
¿Qué campos merece la pena extraer?
Un recibo básico podría generar:
- proveedor;
- fecha;
- subtotal;
- impuestos;
- total;
- moneda;
- forma de pago.
Pero una empresa puede necesitar también:
- entidad legal;
- centro de coste;
- proyecto;
- empleado;
- país;
- número fiscal;
- tipo de gasto;
- número de factura.
Cada nuevo campo tiene un coste.
No extraigas información porque «la IA puede».
Extrae aquello que alimenta una decisión o un registro.
El coste por campo puede revelar automatizaciones inútiles
Supongamos que extraer automáticamente «método de pago» requiere una integración adicional.
Pero nadie utiliza ese campo.
Entonces tenemos:
coste + complejidad + riesgo
sin beneficio.
Antes de diseñar el schema, pregunta:
¿Quién utiliza este campo después?
Si nadie puede responder, probablemente no sea necesario.
El benchmark correcto debe utilizar tus propios recibos
Una demo con 20 documentos perfectos no dice mucho.
Construye un conjunto real.
Por ejemplo:
500 recibos históricos.
Incluye:
- distintos países;
- monedas;
- fotos malas;
- restaurantes;
- combustible;
- hoteles;
- facturas digitales;
- recibos térmicos.
Después crea valores correctos revisados por humanos.
Eso será tu ground truth.
Mide precisión por campo
Ejemplo:
| Campo | Precisión |
|---|---|
| Proveedor | 98,7% |
| Fecha | 99,1% |
| Total | 99,5% |
| IVA | 93,4% |
| Número documento | 87,2% |
| Categoría | 91,8% |
Ahora sabemos dónde existe el problema.
Decir:
«Nuestra IA tiene 95% de precisión»
es mucho menos informativo.
La importancia de los errores tampoco es igual
Confundir:
Restaurante Central
con:
Restaurante Centra
puede ser poco grave.
Confundir:
€18,90
con:
€189,00
es crítico.
Por eso, además de precisión deberíamos medir impacto del error.
Una matriz podría ser:
| Campo | Error | Riesgo |
|---|---|---|
| Nombre proveedor | Ortografía | Bajo |
| Categoría | Incorrecta | Medio |
| IVA | Incorrecto | Alto |
| Total | Incorrecto | Crítico |
| Moneda | Incorrecta | Crítico |
Ahora los thresholds pueden variar.
Automatiza según riesgo, no según una confianza universal
Por ejemplo:
Autoaprobar
Total < €50
Proveedor conocido
Todos los checks matemáticos correctos
Confianza alta
Revisar
€50–€500
Proveedor nuevo
Categoría incierta
Revisión obligatoria
€500
Moneda desconocida
Inconsistencia fiscal
Total ambiguo
Posible duplicado
Esto puede producir un sistema mucho más seguro.
El objetivo real es reducir la cola humana
Supongamos:
10.000 recibos mensuales.
Antes:
10.000 revisiones.
Después:
8.200 autoaprobados bajo reglas seguras.
1.300 necesitan comprobación rápida.
500 presentan excepciones reales.
La IA no eliminó al contador.
Transformó:
10.000 tareas
en:
500 problemas interesantes.
Ese es el ROI que deberíamos medir.
¿Cuánto puede ahorrar?
Supongamos que introducir un recibo manualmente necesita:
90 segundos.
10.000 recibos:
15.000 minutos = 250 horas.
Si el nuevo proceso reduce la intervención media a 20 segundos:
3.333 minutos ≈ 55,5 horas.
Ahorro:
194,5 horas mensuales.
A $25/hora:
$4.862,50 de capacidad mensual.
Ahora podemos comparar ese valor con:
- APIs;
- infraestructura;
- desarrollo;
- revisión;
- mantenimiento.
La automatización deja de ser una demo y se convierte en business case.
No ignores el coste por documento
Las APIs suelen cobrar según uso, modelo, páginas, tokens u otras unidades.
Por eso, calcula:
Coste total mensual / documentos correctamente procesados.
No:
coste por llamada.
Una llamada barata que necesita tres reintentos puede ser más cara que una extracción más robusta.
Los precios de Gemini API y Document AI deben verificarse directamente porque pueden cambiar según modelo, volumen y servicio.
Un modelo más barato puede ganar con routing
No necesitas enviar cada recibo al modelo más potente.
Podemos diseñar:
Ruta A
Documento limpio y proveedor conocido.
→ OCR/procesador económico.
Ruta B
Documento complejo.
→ Gemini.
Ruta C
Baja confianza.
→ humano.
Eso se conoce conceptualmente como routing.
La sofisticación se utiliza únicamente donde aporta valor.
La IA más cara debería recibir los casos difíciles
Supongamos:
80% de documentos son fáciles.
20% difíciles.
Procesar todo con el sistema más avanzado puede ser innecesario.
Si un pipeline barato resuelve correctamente el 80%, el modelo avanzado solo necesita trabajar sobre:
2.000 de 10.000 documentos.
Esto puede cambiar drásticamente el coste.
Batch processing puede cambiar la economía
En grandes volúmenes, también conviene evaluar opciones de procesamiento por lotes cuando el proveedor las ofrece.
Un recibo de gasto de ayer quizá no necesita respuesta en 300 milisegundos.
Si puede procesarse durante la noche, un workflow batch puede ser más económico que procesamiento inmediato.
La pregunta es:
¿Necesitamos velocidad o throughput?
No son lo mismo.
La privacidad debe diseñarse antes del upload
Un recibo puede revelar:
- nombre;
- tarjeta;
- ubicación;
- hábitos;
- empresa;
- identificadores fiscales.
Por eso, antes de enviar documentos a servicios externos hay que revisar:
- qué datos se procesan;
- dónde;
- retención;
- permisos;
- configuración;
- requisitos contractuales.
Google publica documentación específica sobre seguridad y tratamiento de datos en sus servicios empresariales y APIs, que debería revisarse según el producto utilizado. Google Cloud Security
Minimización también puede ocurrir después de extracción
Quizá necesitemos conservar:
proveedor + fecha + importe.
Pero no:
fotografía completa del recibo indefinidamente.
Eso depende de obligaciones legales y políticas documentales aplicables, pero revela una cuestión importante:
capturar un dato no significa que debamos conservarlo para siempre.
Retención y extracción son decisiones distintas.
El audit trail importa cuando algo sale mal
Supongamos que encontramos un gasto incorrecto seis meses después.
Necesitamos saber:
- documento original;
- extracción inicial;
- modelo o procesador;
- resultado;
- regla aplicada;
- modificación humana;
- registro final.
Sin trazabilidad, el sistema se convierte en una caja negra.
Con trazabilidad, podemos descubrir:
«El OCR leyó correctamente €84, pero una regla posterior cambió el valor.»
Ahora sabemos qué corregir.
El error puede no estar donde parece
Este es uno de los mayores beneficios de dividir el pipeline.
Si el registro final está equivocado, podemos preguntar:
¿La imagen estaba mal?
↓
¿OCR falló?
↓
¿Extracción falló?
↓
¿Validación falló?
↓
¿Matching falló?
↓
¿Clasificación falló?
↓
¿Integración falló?
La palabra «error de IA» deja de ser suficientemente precisa.
¿Gemini sustituye al software contable?
No.
Gemini puede convertirse en una capa de interpretación.
Todavía necesitas un sistema que gestione:
- libro;
- cuentas;
- reconciliación;
- periodos;
- informes;
- controles.
Herramientas como Zoho Books, QuickBooks y otras plataformas cumplen esa función.
En Automatización de Contabilidad con IA: Booke vs Zoho Books vs Wave analizamos precisamente la diferencia entre automatizar documentos y operar dentro del sistema contable.
Un workflow completo podría funcionar así
Empleado fotografía recibo
↓
Sistema comprueba calidad
↓
OCR / Gemini extrae campos
↓
Reglas validan números
↓
Sistema busca duplicados
↓
Proveedor se normaliza
↓
IA propone categoría
↓
Reglas calculan nivel de riesgo
↓
Casos seguros → software contable
Casos dudosos → revisión humana
Eso es muy diferente de:
«Subimos recibos a Gemini.»
La herramienta es solo una pieza.
¿Gemini u OCR tradicional?
Elige OCR/document processing especializado cuando:
- documentos son repetitivos;
- campos están bien definidos;
- necesitas volumen;
- el workflow es estable.
Considera Gemini cuando:
- formatos cambian mucho;
- necesitas interpretación contextual;
- existen documentos difíciles;
- quieres combinar imagen + instrucciones.
Combina ambos cuando:
- tienes mucho volumen;
- una minoría de documentos genera la mayoría de errores.
Esta tercera opción suele ser especialmente interesante.
El mejor KPI final no es precisión del OCR
Podríamos alcanzar:
99,5% de caracteres correctos
y aun tener un proceso malo.
Un KPI más próximo al negocio sería:
Porcentaje de documentos que llegan correctamente al sistema contable sin intervención humana.
Después:
errores críticos por 1.000 documentos.
Y finalmente:
minutos humanos por 100 documentos.
Estas métricas conectan tecnología con trabajo real.
La automatización termina cuando desaparece una decisión innecesaria
El objetivo no debería ser que Gemini «entienda recibos como una persona».
Debería ser que una persona ya no tenga que mirar cientos de documentos donde no existe ninguna duda real.
Que el sistema procese:
- documentos claros;
- importes consistentes;
- proveedores conocidos;
- transacciones normales.
Y que el profesional reciba únicamente:
17 recibos de 1.000 que necesitan una decisión.
Ahí la IA deja de ser una herramienta llamativa.
Se convierte en infraestructura.
Y esa puede ser la diferencia entre digitalizar un proceso y realmente automatizarlo.