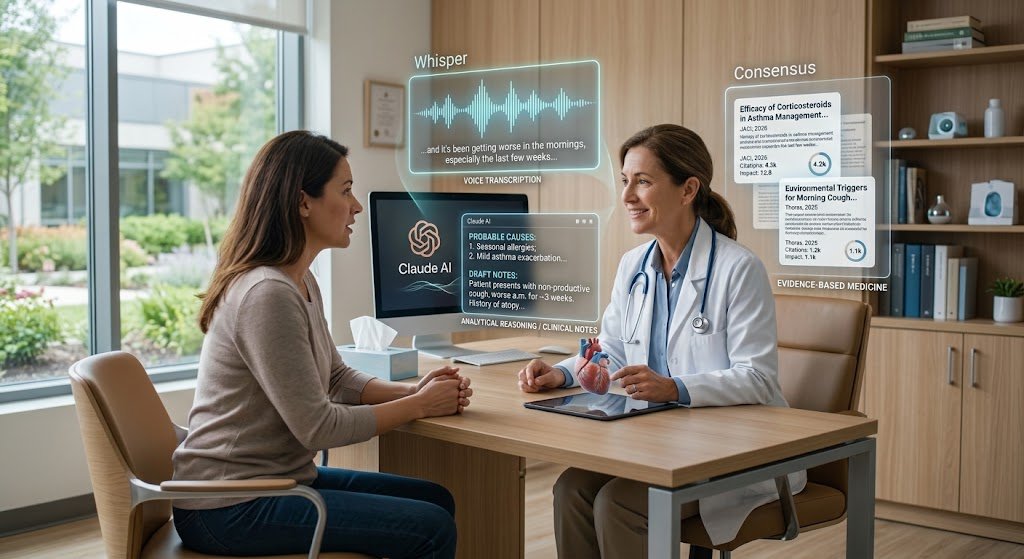
IA para Médicos de Familia: Claude + Consensus + Whisper
Un médico de familia rara vez tiene un único problema que la inteligencia artificial pueda resolver.
Durante una misma mañana puede necesitar:
- convertir una conversación en notas;
- resumir antecedentes;
- revisar un documento largo;
- buscar evidencia reciente;
- explicar un tratamiento en lenguaje comprensible;
- preparar instrucciones para el paciente;
- decidir qué información todavía falta.
Eso significa que probablemente no exista una única «mejor IA para medicina de familia».
Puede ser más útil combinar herramientas con funciones distintas.
Un stack sencillo podría ser:
Whisper o speech-to-text
para convertir voz en texto.
Claude
para estructurar, resumir y revisar información.
Consensus
para localizar literatura científica verificable.
Pero existe una regla que cambia completamente cómo deberíamos usar las tres:
cada herramienta debe resolver una parte diferente del workflow y ninguna debería convertirse automáticamente en la fuente final de la decisión clínica.
Ese enfoque evita pagar tres herramientas para hacer exactamente lo mismo y, sobre todo, reduce el riesgo de convertir un chatbot generalista en un sistema diagnóstico improvisado.
El médico de familia tiene un problema especialmente difícil para la IA
Especialistas suelen trabajar dentro de un espacio clínico relativamente definido.
La atención primaria puede recibir en el mismo turno:
- hipertensión;
- dolor lumbar;
- insomnio;
- infección respiratoria;
- diabetes;
- ansiedad;
- revisión de medicamentos;
- síntomas inespecíficos.
El médico cambia de contexto continuamente.
Por eso, una ferramenta que funciona extraordinariamente para una única área puede ser menos útil que um stack flexível de herramientas generales bien delimitadas.
La pregunta no es:
«¿Cuál IA sabe más medicina?»
Es:
¿Qué tarea repetitiva aparece entre prácticamente todas las consultas?
Tres tareas aparecen continuamente
1. Capturar información
La consulta genera voz y datos.
2. Transformar información
Esa información necesita convertirse en:
- nota;
- resumen;
- checklist;
- instrucciones.
3. Verificar información
Cuando aparece una pregunta clínica, el médico necesita volver a:
- evidencia;
- guideline;
- paper;
- fuente oficial.
Whisper, Claude y Consensus pueden mapearse aproximadamente sobre esas tres etapas.
Whisper: convertir voz en una entrada utilizable
Whisper es un sistema de reconocimiento automático del habla desarrollado por OpenAI.
Fue entrenado originalmente sobre 680.000 horas de audio supervisado multilingüe y multitarea y puede realizar reconocimiento de voz en múltiples idiomas.
En 2026, OpenAI sigue ofreciendo whisper-1 en su API y también dispone de modelos de transcripción más recientes orientados a speech-to-text y escenarios de baja latencia.
Para un médico, sin embargo, la pregunta práctica no es:
«¿Qué modelo ASR tiene mejor benchmark?»
Es:
¿Qué partes de mi documentación empiezan como voz y terminan siendo texto escrito manualmente?
Dictado y ambient AI no son exactamente lo mismo
Con dictado:
el médico habla deliberadamente para producir una nota.
Con ambient AI:
médico y paciente conversan normalmente y el sistema intenta reconstruir la documentación.
Son problemas diferentes.
Whisper es principalmente una tecnología de transcripción.
No debería confundirse automáticamente con un producto completo de ambient clinical documentation como Dragon Copilot o Nabla.
Eso importa porque:
speech-to-text ≠ clinical note.
Entre ambos todavía necesitamos:
- selección;
- estructura;
- revisión;
- interpretación.
Un workflow básico con Whisper podría ser extremadamente simple
Después de la consulta, el médico dicta:
Paciente mujer de 52 años con dolor lumbar desde hace cinco días. No refiere fiebre. Niega trauma reciente. Se discutieron signos de alarma y seguimiento si aparecen nuevos síntomas.
Whisper convierte audio en texto.
Después, Claude puede transformar esa transcripción en una estructura.
Eso ya elimina parte del teclado sin permitir que la IA escuche toda la consulta.
Para determinadas clínicas, este workflow más limitado puede ser más fácil de gobernar que ambient recording completo.
Este enfoque tiene una ventaja de privacidad: minimizar la captura
Supongamos que una consulta dura:
20 minutos.
Pero la información necesaria para la nota puede resumirse mediante:
90 segundos de dictado posterior.
Ahora el sistema procesa mucho menos audio.
Menos audio puede significar:
- menos información personal capturada;
- menos conversación irrelevante;
- menor superficie de almacenamiento;
- revisión más sencilla.
Eso no elimina obligaciones de privacidad.
Pero muestra un principio importante:
la mejor automatización no siempre es la que captura más contexto.
A veces es la que necesita menos.
Whisper también puede fallar en aquello que parece pequeño
Considere:
«quince miligramos»
transcrito como:
«cincuenta miligramos.»
O:
«sin alergia»
como:
«alergia.»
Un transcript puede estar 99% correcto y seguir conteniendo un error clínicamente importante.
Por eso, para información crítica deberían existir verificaciones específicas.
Especialmente:
- medicamentos;
- dosis;
- alergias;
- fechas;
- números.
La precisión global no es la métrica correcta
Una transcripción de 1.000 palabras tiene:
990 correctas.
Precisão:
99%.
Pero las diez incorrectas incluyen:
- nombre del medicamento;
- dosis;
- frecuencia.
Para documentación clínica, eso puede ser inaceptable.
La auditoría debería clasificar errores por consecuencia.
No solo por cantidad.
Whisper puede ser especialmente útil para notas internas y tareas administrativas
Ejemplos de menor riesgo:
- dictar tareas pendientes;
- convertir ideas en texto;
- preparar borradores;
- resumir una reunión;
- capturar notas no clínicas.
Estos casos pueden ser mejores para comenzar que intentar automatizar inmediatamente toda la consulta.
Claude entra después de la captura
Claude puede trabajar con textos y documentos largos y Anthropic ha ampliado expresamente su oferta para healthcare y life sciences durante 2026.
Anthropic destaca actualmente casos como:
- documentación clínica;
- revisión de literatura;
- trabajo con información biomédica;
- automatización de determinados workflows sanitarios.
Para medicina de familia, su valor principal puede estar en transformar información desordenada en estructuras que el médico pueda revisar.
No pidas «haz la nota»
Un prompt demasiado abierto:
Convierte esto en una nota clínica.
Puede producir una nota atractiva.
Pero también puede:
- reorganizar de más;
- aumentar certeza;
- añadir lenguaje no dicho;
- interpretar implícitamente.
Una instrucción más segura:
Utiliza exclusivamente la transcripción proporcionada.
Organiza la información en:
- motivo;
- historia;
- síntomas positivos;
- síntomas negativos explícitamente mencionados;
- evaluación mencionada;
- plan discutido.
No añadas diagnósticos, examen físico, medicamentos ni negativas que no aparezcan en el texto.
Si falta información, escribe «no documentado».
A palavra mais importante é:
no documentado.
«No documentado» protege contra completado automático
Imagine:
Na transcrição não aparece:
fiebre.
O modelo pode assumir:
no fever.
Isso seria errado.
A ausência de menção não é uma negativa clínica.
Por isso:
no mencionado
e
negado explicitamente
precisam ser categorias separadas.
Esse pequeno detalhe aumenta muito a confiabilidade do workflow.
Claude pode ser mais útil como revisor do que como redator
Outro uso:
Analiza esta nota y señala exclusivamente:
- datos contradictorios;
- medicamentos mencionados con diferentes dosis;
- fechas inconsistentes;
- información potencialmente relevante que aparece en la transcripción pero falta en la nota.
No reescribas el documento.
Agora a IA procura diferença.
Isso pode gerar mais valor que produzir outro texto.
Um exemplo de contradição que a IA pode encontrar
História:
sintomas há três dias.
Plano:
persistência de sintomas durante três semanas.
Pode ser:
- typo;
- informação nova;
- erro de transcrição.
A IA não precisa decidir qual é correta.
Precisa sinalizar:
hay una discrepancia temporal.
Essa é uma função de baixo risco relativamente fácil de verificar.
O médico de família também recebe muitos documentos
- alta hospitalar;
- relatórios;
- resultados;
- cartas de especialistas;
- políticas;
- documentação do paciente.
Claude pode reduzir um documento longo a perguntas específicas.
Em vez de:
Resume este informe.
Pergunte:
Extrae únicamente:
- nuevos diagnósticos;
- cambios de medicación;
- pruebas pendientes;
- seguimiento recomendado;
- señales de alarma;
- fechas futuras.
Indica en qué parte del documento aparece cada elemento.
Agora o resumo tem uma finalidade clínica clara.
O melhor resumo é aquele que reduz uma ação esquecida
Imagine um relatório de 17 páginas.
A informação mais relevante para atenção primária é:
repetir creatinina em quatro semanas.
Se o resumo omite isso, pouco importa que as outras 16 páginas tenham sido resumidas perfeitamente.
Portanto, a avaliação deve perguntar:
A IA encontrou as ações pendentes?
Não apenas:
o resumo parece bom?
Crie um checklist de «ações que não podem desaparecer»
Por exemplo:
- nova medicação;
- medicação suspensa;
- exame pendente;
- referral;
- follow-up;
- warning sign;
- resultado crítico.
Claude pode revisar explicitamente essas categorias.
Isso reduz risco de compressão excessiva.
Consensus entra quando surge uma pergunta de evidência
Consensus é um buscador acadêmico com IA que atualmente trabalha sobre uma base superior a 220 milhões de papers revisados por pares, segundo sua própria documentação, atualizada semanalmente.
Sua função é muito diferente de Claude.
Em vez de perguntar ao modelo:
¿Qué dice la medicina sobre este tratamiento?
podemos utilizar uma ferramenta dedicada a recuperar literatura científica.
Isso melhora o workflow:
pergunta clínica
↓
Consensus encontra papers
↓
médico verifica estudos/fontes
↓
conclusão.
Consensus também pode ler mais que abstracts quando disponível
Em 2026, a plataforma expandiu parcerias com publishers e afirma conseguir trabalhar com full text de determinados papers, inclusive material de grandes editoras quando disponível.
Isso pode melhorar síntese.
Mas não elimina a necessidade de verificar o paper original.
Especialmente quando uma decisão depende de:
- subgroup;
- endpoint;
- métodos;
- limitações.
O médico de família não precisa fazer revisão sistemática a cada consulta
Essa é uma consideração prática.
Imagine:
paciente pergunta sobre benefício de uma intervenção.
O médico tem:
3 minutos.
Uma busca completa seria inviável.
Um workflow possível:
Primeiro
Consensus:
¿Qué revisiones sistemáticas o ensayos recientes existen?
Depois
Identificar:
- guideline;
- systematic review;
- estudo principal.
Finalmente
Abrir a fonte.
Isso transforma 200 resultados em três leituras prioritárias.
Não use o Consensus Meter como votação médica
Consensus oferece o Consensus Meter, que mostra se a literatura recuperada tende a «Yes», «No», «Possibly» ou «Mixed» em certas perguntas.
Esse recurso é útil para orientação.
Mas:
7 estudos dizendo sim
não necessariamente vencem:
2 estudos dizendo não.
Qualidade metodológica continua importando.
Por isso, Consensus ajuda a descobrir padrão.
Não substitui avaliação de evidência.
O stack funciona melhor quando cada ferramenta tem uma fronteira
Uma estrutura clara poderia ser:
Whisper
Captura.
Não conclui.
Claude
Estrutura e critica.
Não é fonte clínica primária.
Consensus
Recupera literatura.
Não substitui leitura/verificação.
Médico
Integra contexto e decide.
Essa separação é mais importante que escolher a versão mais avançada de cada modelo.
O erro começa quando as fronteiras desaparecem
Workflow perigoso:
Whisper grava consulta.
Claude interpreta.
Claude sugere diagnóstico.
Claude sugere tratamento.
Texto entra no prontuário.
Nenhuma fonte foi verificada.
Aparentemente eficiente.
Mas uma única ferramenta acumulou funções demais.
Um workflow mais seguro introduz pontos de controle
voz
↓
transcrição
↓
verificação de campos críticos
↓
estrutura
↓
revisão médica
↓
pergunta clínica
↓
Consensus
↓
fonte original
↓
decisão médica.
Cada seta elimina um tipo de incerteza.
Um exemplo completo: hipertensão
Paciente relata:
- medidas domiciliares elevadas;
- tontura ocasional;
- adesão irregular;
- medicamento atual.
Whisper
Transcreve o ditado.
Claude
Estrutura:
- sintomas;
- valores relatados;
- medicamento;
- adesão;
- questões ainda não documentadas.
Médico percebe
Falta saber:
- como pressão é medida em casa;
- padrão temporal;
- outros medicamentos.
Consensus
É utilizado apenas se surge uma dúvida específica de evidência.
Por exemplo:
efectividad comparativa de determinada estrategia en población semejante.
Assim, a IA não «tratou hipertensão».
Ela reduziu tarefas ao redor da avaliação.
Outro exemplo: dor lombar
O paciente entrega um relatório de urgência de oito páginas.
Claude
Extrai:
- imaging;
- red flags documentados;
- medicação;
- follow-up.
Médico
Confirma no documento.
Consensus
Pode ajudar se houver pergunta específica sobre evidência de determinada intervenção.
Whisper
Captura o plano discutido.
Três ferramentas.
Três tarefas.
Nenhuma precisa ser «o médico».
O stack também pode economizar tempo entre consultas
Suponha:
Documentação
2 minutos economizados por consulta.
Leitura documental
10 minutos economizados em três casos/dia.
Pesquisa
5 minutos economizados em duas perguntas.
Total aproximado:
20 pacientes × 2 min = 40 min.
Documentos:
30 min.
Pesquisa:
10 min.
Total:
80 minutos por dia.
Em cinco dias:
6 horas e 40 minutos semanais.
Não é uma promessa.
É um modelo de cálculo para que a clínica faça sua própria medição.
O erro seria declarar ROI antes do piloto
Um médico pode ser extremamente rápido documentando.
Para ele:
Whisper + Claude pode economizar quase nada.
Outro perde duas horas toda noite.
Para ele:
o mesmo stack pode mudar a jornada.
E-E-A-T exige que não transformemos um cenário hipotético em resultado universal.
Como medir um piloto de quatro semanas
Semana 1 — Baseline
Registre:
- tempo pós-consulta;
- tempo lendo documentos;
- número de pesquisas;
- notas depois do expediente.
Semana 2 — Whisper
Automatize apenas captura/dictado.
Semana 3 — Claude
Adicione estrutura e revisão documental.
Semana 4 — Consensus
Adicione busca bibliográfica para perguntas selecionadas.
Isso permite saber qual ferramenta produziu qual ganho.
Se instalar as três no primeiro dia, você perde essa informação.
A melhor métrica é tempo até tarefa concluída
Para Whisper:
áudio → transcrição verificada.
Para Claude:
documento → resumo validado.
Para Consensus:
pergunta → fonte clínica verificável.
Não:
velocidade de resposta do modelo.
Também meça retrabalho
Whisper economiza:
10 minutos.
Mas requer:
8 minutos corrigindo.
Economia real:
Claude economiza:
12 minutos.
Mas resumo perde informação e obriga voltar ao documento inteiro.
Economia:
talvez zero.
O ROI precisa ser líquido.
Um dashboard simples
| Workflow | Antes | Depois | Ganho |
|---|---|---|---|
| Dictado/nota | 6 min | 3 min | 3 min |
| Informe largo | 12 min | 4 min | 8 min |
| Búsqueda clínica | 10 min | 5 min | 5 min |
Depois adicione:
erros e retrabalho.
Essa última coluna pode mudar totalmente a decisão.
Claude e Consensus agora podem trabalhar mais próximos
Em 2026, Consensus expandiu suas integrações e informa que pode ser utilizado com Claude via MCP, além de outros ambientes de IA.
Isso sugere um workflow mais integrado:
Claude
faz análise.
Quando necessita literatura:
Consensus retrieval
entra.
Mas integração não elimina a necessidade de distinguir:
conclusão do modelo
de
evidência recuperada.
A citação precisa permanecer visível
Um bom output deveria dizer algo como:
Esta afirmación está respaldada por los estudios A, B y C.
Não apenas:
«Según la evidencia…»
O médico precisa conseguir sair da resposta e chegar ao paper.
Esse princípio também foi central no artigo Búsqueda Bibliográfica con IA: Consensus, Perplexity y PubMed.
PubMed continua sendo uma camada importante
Mesmo utilizando Consensus, PubMed continua útil para:
- verificar referência;
- revisar abstract;
- confirmar publicação;
- ampliar a busca.
Um stack responsável pode ser:
Consensus → PubMed → paper.
A IA acelera descoberta.
A infraestrutura biomédica verifica identidade da fonte.
Claude não deveria substituir Consensus para pesquisa médica
Claude pode trabalhar com literatura biomédica e Anthropic vem ampliando suas soluções para healthcare e life sciences.
Mas uma ferramenta dedicada de busca acadêmica tem outra vantagem:
o retrieval foi construído especificamente sobre um corpus científico.
Por isso, para perguntas de literatura, faz sentido separar:
reasoning tool
de:
search corpus.
Essa arquitetura aumenta controle.
Whisper já não é necessariamente a opção mais moderna da própria OpenAI
Esse é um detalhe importante de 2026.
Embora Whisper continue disponível, OpenAI lançou novos modelos de speech-to-text e, em maio de 2026, apresentou uma opção de transcrição em tempo real de baixa latência.
Isso significa que o título «Claude + Consensus + Whisper» deve ser interpretado como uma arquitetura:
LLM + research search + speech-to-text
e não como obrigação de usar exatamente whisper-1.
Em um projeto novo, vale comparar os modelos de transcrição atuais.
Isso é um bom exemplo de Trustworthiness editorial:
o nome popular pode continuar relevante mesmo quando a tecnologia mais recente mudou.
Qual modelo de transcrição escolher?
Não compare somente preço.
Teste:
- espanhol;
- sotaques locais;
- termos médicos;
- ruído;
- múltiplos falantes;
- nomes de fármacos.
Um modelo com menor WER global pode não ser o melhor no vocabulário da sua clínica.
Crie seu próprio benchmark
Grave, com dados apropriados e autorizados, um conjunto de exemplos ou utilize material sintético que represente:
- nomes de medicamentos;
- doses;
- sintomas;
- números;
- termos técnicos.
Depois compare.
Exemplo:
100 frases críticas.
Whisper/modelo A:
95 corretas.
Modelo B:
Mas:
Modelo B erra duas doses.
Modelo A erra termos não críticos.
Qual é melhor?
Novamente:
gravidade > média.
Privacidade é o principal freio desse stack
Whisper pode processar voz.
Claude pode processar texto clínico.
Consensus pode receber perguntas médicas.
Uma arquitetura mal desenhada pode espalhar dados do paciente entre múltiplos fornecedores.
Por isso, antes de usar dados reais, mapeie:
que dado vai para qual ferramenta.
Não envie identificação ao Consensus se a pergunta não precisa dela
Pergunta ruim:
Mi paciente María García, 64 años, identificada con documento X, tiene…
Pergunta adequada:
En adultos de 60–70 años con [condición], ¿qué evidencia existe sobre…?
A busca científica normalmente não precisa de identidade.
A minimização reduz risco sem reduzir qualidade.
O mesmo vale para Claude
Talvez um relatório possa ser processado após remover:
- nome;
- ID;
- contato;
- endereço.
Isso depende do uso, contexto e política da organização, mas o princípio permanece:
não forneça dado que a tarefa não precisa.
Nos Estados Unidos, produtos comerciais exigem avaliação de HIPAA
Anthropic lançou em janeiro de 2026 uma oferta ampliada para healthcare e life sciences, com foco em workflows regulados e integração com ecossistemas de saúde.
Mesmo assim, uma instituição precisa avaliar:
- produto específico;
- contrato;
- BAA quando aplicável;
- configuração;
- retenção;
- acesso.
«Claude pode ser usado em healthcare» não significa:
qualquer conta Claude pode receber qualquer PHI.
Para Whisper/OpenAI, a mesma lógica se aplica
É necessário avaliar o serviço específico e as condições atuais da API, incluindo:
- retenção;
- tratamento;
- controles empresariais;
- exigências institucionais.
A documentação atual de speech-to-text está disponível na OpenAI API.
As políticas devem ser verificadas antes da implementação.
Na Europa, GDPR adiciona outra camada
Dados de saúde pertencem a categorias especialmente protegidas.
Uma clínica europeia precisa avaliar:
- finalidade;
- base jurídica;
- minimização;
- segurança;
- transferência;
- retenção;
- contratos.
Três boas ferramentas individualmente podem formar um stack inadequado se o fluxo de dados não for governado.
Um diagrama simples ajuda
Por exemplo:
consulta
↓
Whisper recebe apenas ditado pós-consulta
↓
transcrição sem identificadores desnecessários
↓
Claude cria estrutura
↓
nota revisada
↓
EHR.
Consensus só recebe:
pergunta clínica abstrata.
Agora o fluxo é muito diferente de enviar a gravação inteira para todos os sistemas.
Isso é data minimization aplicada ao design
Privacidade não entra depois.
Entra na arquitetura.
Esse é um padrão importante para IA clínica.
Quando esse stack faz sentido?
Especialmente para médicos de família que:
- têm alto volume;
- documentam muito;
- recebem documentos longos;
- pesquisam evidência frequentemente;
- não precisam de um sistema enterprise integrado desde o primeiro dia.
Quando não faz sentido?
Se a clínica já possui:
- ambient AI integrado ao EHR;
- evidence search institucional;
- automação documental.
Adicionar Claude + Consensus + Whisper pode apenas duplicar funções.
Antes de contratar, mapeie ferramentas já existentes.
Um stack barato pode sair caro se exigir cinco transferências
Exemplo:
gravar áudio.
baixar.
subir.
copiar transcrição.
colar em Claude.
copiar nota.
colar no EHR.
Mesmo que cada IA seja rápida, o workflow é lento.
Integração precisa entrar no cálculo.
O stack ideal reduz passos
Objetivo:
voz → nota revisável
e
pergunta → evidência verificável.
Quanto menos transições manuais, maior o ganho potencial.
Mas automatize as transições apenas depois de validar qualidade.
Não automatize o envio final no primeiro dia
Por exemplo:
Whisper → Claude → EHR automaticamente.
Isso remove uma barreira de revisão.
Melhor inicialmente:
Whisper → Claude → draft → médico → EHR.
Depois de centenas de casos avaliados, a organização pode decidir se outras etapas podem ser automatizadas.
Use thresholds de risco
Baixo risco
- resumo administrativo;
- texto educativo;
- estrutura.
Maior automação.
Médio
- nota clínica.
Revisão obrigatória.
Alto
- medicamentos;
- diagnóstico;
- conduta.
Controle clínico forte.
Isso evita tratar todas as saídas da mesma forma.
Claude pode ajudar com material educativo para pacientes
Exemplo:
Reescribe estas instrucciones médicas ya validadas para un nivel de lectura sencillo.
No añadas nuevas recomendaciones.
Isso pode ser muito útil em atenção primária.
O médico fornece o conteúdo clínico correto.
Claude adapta a linguagem.
Esse é um uso onde geração de linguagem pode aportar valor com uma fronteira clara.
Outra aplicação: traduzir complexidade, não inventar medicina
Texto original:
monitorizar la presión arterial domiciliaria dos veces al día durante siete días.
Versão simplificada:
Mida su presión dos veces al día, una vez por la mañana y otra por la tarde, durante una semana.
A informação é a mesma.
A clareza muda.
Mas tradução para outro idioma precisa de controle
Termos médicos e instruções críticas podem sofrer alterações.
Para conteúdo de alto risco:
- revisar;
- usar intérprete quando necessário;
- seguir política institucional.
IA pode ajudar.
Não deve ser a única barreira de comunicação.
Outra função útil: preparar agenda da consulta seguinte
A partir de uma nota validada:
Extrae las tareas pendientes para la próxima visita.
No añadas nuevas recomendaciones.
Output:
- revisar pressão domiciliar;
- verificar exame;
- discutir tolerância ao medicamento.
Agora a IA transforma texto em checklist.
Isso reduz tarefas esquecidas.
O médico deve definir o que nunca pode ser inferido
Uma política simples:
A IA não deve criar por inferência:
- diagnóstico;
- exame físico;
- alergia;
- medicamento;
- dose;
- consentimento;
- resultado de teste.
Se não estiver na fonte:
no documentado.
Isso pode ser incorporado ao prompt padrão.
O melhor prompt vira um protocolo
Em vez de cada médico improvisar:
“faz uma nota.”
A clínica pode criar um template aprovado.
Isso melhora:
- consistência;
- treinamento;
- auditoria.
E facilita comparar erros ao longo do tempo.
Monitorar correções produz aprendizado organizacional
Se 30 médicos corrigem repetidamente:
- duração;
- negativa;
- formato de plano,
isso indica problema sistemático.
Você pode:
- ajustar prompt;
- mudar workflow;
- trocar modelo.
Sem registro, cada erro parece isolado.
E-E-A-T aplicado ao stack
Experience
Piloto com consultas e documentos representativos do ambiente real.
Expertise
Médicos definem templates, campos críticos e critérios de revisão.
Authoritativeness
Consensus, PubMed, guidelines e papers originais para afirmações clínicas.
Trustworthiness
Privacidade, fontes visíveis, «no documentado», auditoria e limites explícitos.
Essa combinação é mais importante que ter o modelo com maior benchmark.
O que eu implementaria primeiro?
Se começasse em uma clínica de atenção primária:
Fase 1
Whisper ou outro speech-to-text para ditado não crítico.
Fase 2
Claude para estruturar ditados e resumir documentos.
Fase 3
Consensus para perguntas bibliográficas.
Fase 4
Integrações, somente depois de medir qualidade.
Essa ordem mantém complexidade baixa no início.
O que medir depois de 30 dias?
- minutos de documentação por consulta;
- tempo lendo documentos;
- pesquisas realizadas;
- tempo até fonte verificável;
- erros de transcrição;
- correções clínicas;
- notas pós-expediente;
- satisfação.
Se apenas satisfação melhora, é bom.
Se tempo também cai sem aumento de erro, temos um case mais forte.
Não procure uma redução de 100%
Objetivo realista:
remover trabalho mecânico.
Não:
remover supervisão médica.
Se um workflow antes leva 10 minutos e depois leva 4:
60% de redução já pode ser enorme.
A melhor combinação pode terminar sendo outra
Depois do piloto você pode descobrir:
Whisper:
excelente.
Claude:
útil.
Consensus:
pouco usado.
Ou:
Consensus gera mais valor que os outros dois.
Isso é exatamente por que medir por componente importa.
Não aceite a ideia de que o stack precisa sobreviver completo.
O melhor software é aquele que merece continuar
Cada ferramenta deveria precisar justificar sua presença.
Pergunta mensal:
¿Qué tarea concreta desapareció gracias a esta suscripción?
Se a resposta é vaga:
talvez não seja necessária.
Como isso se relaciona com ambient AI?
No artigo DAX Copilot para Notas Clínicas: Cómo Eliminar la Documentación Fuera del Horario vimos uma abordagem muito mais integrada de ambient documentation.
Claude + speech-to-text pode ser uma alternativa modular.
Dragon Copilot é uma solução mais integrada.
A melhor escolha depende de:
- EHR;
- escala;
- orçamento;
- governança.
E com pesquisa bibliográfica?
Em Búsqueda Bibliográfica con IA: Consensus, Perplexity y PubMed vimos que Consensus é melhor entendido como camada de descoberta científica.
Não como autoridade final.
Esse princípio continua aqui.
E com diagnóstico?
No artigo IA para Diagnóstico Clínico: Med-PaLM 2, Consensus y Herramientas Validadas vimos por que um chatbot que consegue raciocinar clinicamente não se transforma automaticamente em ferramenta diagnóstica validada.
Isso é especialmente importante para Claude.
Seu papel neste stack deveria permanecer bem definido.
A conclusão mais importante
Claude + Consensus + Whisper pode ser um stack poderoso para medicina de família.
Mas não porque três IAs juntas «sabem mais medicina».
O valor surge quando cada uma reduz uma forma diferente de fricção:
Whisper
reduz teclado.
Claude
reduz desorganização.
Consensus
reduz tempo até literatura relevante.
E o médico continua responsável por aquilo que nenhuma delas deveria assumir:
entender o paciente inteiro.
Se o stack consegue devolver 45 minutos por dia sem aumentar erros, já pode ser um excelente resultado.
Não precisamos que diagnostique autonomamente.
Não precisamos que substitua o médico.
Precisamos que transforme:
duas horas de trabalho secundário
em:
alguns minutos de revisão focada.
A melhor IA para atenção primária talvez não seja aquela que dá mais respostas.
Pode ser a combinação que consegue garantir que o médico passe menos tempo movendo informação e mais tempo decidindo o que ela significa.
Fuentes y recursos recomendados
- Anthropic — Claude for Healthcare and Life Sciences
- Anthropic — Claude for Life Sciences
- Consensus
- Consensus — Cómo funciona
- Consensus Research Database
- OpenAI — Whisper
- OpenAI API — Speech to Text
- PubMed
- DAX Copilot para Notas Clínicas: Cómo Eliminar la Documentación Fuera del Horario
- Búsqueda Bibliográfica con IA: Consensus, Perplexity y PubMed
- IA para Diagnóstico Clínico: Med-PaLM 2, Consensus y Herramientas Validadas
Revisión editorial: Este artículo fue actualizado con información oficial disponible en agosto de 2026. Whisper continúa disponible, pero OpenAI ya ofrece modelos de transcripción más recientes; por eso se utiliza aquí también como referencia a la capa speech-to-text, no como recomendación automática de un modelo concreto. Anthropic ha ampliado expresamente sus productos para healthcare y life sciences, y Consensus declara actualmente una base superior a 220 millones de papers revisados por pares.
Importante: Este contenido tiene fines exclusivamente educativos e informativos. Claude, Consensus, Whisper y otras herramientas de IA pueden producir errores, omisiones o interpretaciones incorrectas. No sustituyen la evaluación clínica, el diagnóstico, las guías vigentes ni el juicio de profesionales sanitarios cualificados. Antes de procesar información de pacientes, deben evaluarse privacidad, seguridad, contratos, regulación y políticas institucionales aplicables.
Un comentario